

本文系统阐述AI安全态势管理(AI-SPM)的问题定义,指出AI资产因非确定性、边界消失与版本漂移,使CSPM依赖的资产可枚举、状态可判定、结果可复现三条前提全部崩塌。据此提出AI-SPM以遥测为输入、资产关系图为骨架、行为偏离为判据、可执行处置为出口的持续度量体系,厘清其与CSPM、CWPP、AI网关等相邻技术的职责边界,并归纳资产、配置、行为、语料、供应链五项度量对象,强调其核心价值在于跨位置关联而非单点检测。
一、问题定义:AI-SPM 究竟在管什么
把 AI-SPM 讲成“AI 版的 CSPM”,是最常见也最致命的误解。CSPM 之所以成立,依赖三个隐含前提:资产可枚举、状态可判定、结果可复现。云上的一台虚机、一个存储桶,配置项是有限的、快照是可比的、违规判定是可以写成布尔表达式的。AI 资产三条前提全部不成立。
1.1 三条前提的崩塌
非确定性。同一个提示词、同一个模型,两次调用的输出可能完全不同。你不能用“配置是否合规”去判定它,只能观测“它做了什么”。这意味着度量单元从状态快照变成行为轨迹——这是 AI-SPM 与所有传统 SPM 的分水岭。
边界消失。一个 Agent 的权限,不再是静态 ACL 里的一行授权,而是“它能调用哪些工具 × 每个工具能碰哪些数据 × 它能把结果交给谁”的笛卡尔积,并且这个积在运行时由模型的自主决策动态组合。系统提示词里写“禁止删除文件”,不等于它不会删除文件;真正的约束来自工具层的能力边界。
版本漂移。提示词每周改、知识库每天增量、模型权重按季度换。上周通过评估的配置,这周可能已经是一套新的系统。传统 SPM 的“基线—偏离”模型仍然有效,但基线的半衰期从季度缩短到了周。
由此可以给出一句定义:AI-SPM 是一套以遥测为输入、以资产关系图为骨架、以行为偏离为判据、以可执行处置为出口的持续度量系统。它回答的不是“有没有配错”,而是“它现在正在做什么、这算不算异常、如果算,我能在不打断业务的前提下把它按住多久”。
1.2 与相邻技术的边界
把边界划清楚,比把功能堆齐全更重要。市面上的 AI 安全产品几乎都在往“全能”方向长,结果是每一项都做不深。下表给出一种更实用的分工方式——按“观测位置”而不是“功能名称”来划分。
表 1-1相邻技术的职责边界(按观测位置划分)
|
能力 |
观测位置 |
回答的问题 |
输出物 |
典型盲区 |
|
CSPM / 云安全 |
控制面 API |
云资源配置是否符合基线 |
配置项清单、合规分 |
看不见 AI 应用内部行为 |
|
CWPP / 主机安全 |
主机与容器内 |
工作负载是否被入侵 |
进程链、文件与网络事件 |
不懂模型语义与提示词 |
|
AI 网关 |
南北向流量 |
谁在调用哪个模型、花了多少 |
调用日志、Token 计量 |
看不见端内与东西向 |
|
AI-DLP |
内容出口 |
有没有敏感数据出去 |
敏感数据告警 |
缺少攻击意图上下文 |
|
AI-SPM |
全域遥测 + 关系图 |
AI 系统的安全态势如何、风险在哪里、怎么处置 |
资产图谱、风险评分、闭环工单 |
不替代边界防护,不做模型训练 |
这张表有一个隐含判断:AI-SPM 的不可替代性来自“跨位置关联”,而不是“单点检测更强”。网关能看到请求,但看不到发起请求的进程;eBPF 能看到进程,但看不到进程背后的提示词;围栏能看到提示词,但看不到这段提示词是从哪个知识库检索出来的。只有把这些视角对齐到同一个主体、同一条会话上,攻击链才浮出来。
1.3 五项度量对象
AI-SPM 需要持续度量的对象可以收敛为五类。每一类都对应一组具体的采集字段与判定逻辑,而不是一个抽象概念。
表 1-2AI-SPM 的五项度量对象
|
度量对象 |
具体所指 |
关键问题 |
对应探针 |
|
资产 |
模型、提示词、Agent、工具/MCP、知识库、NHI 身份 |
有哪些、谁在用、归属谁、暴露在哪 |
网关 + 端内 + 主动扫描 |
|
配置 |
围栏策略、网关路由、工具授权、模型参数、检索范围 |
策略是否覆盖、是否被旁路、是否漂移 |
围栏 + 网关 |
|
行为 |
调用序列、工具组合、资源占用、输出内容 |
是否偏离基线、是否构成攻击链 |
AIDR + Agent 端点 |
|
数据 |
语料、向量库、微调集、会话记录 |
流向哪、是否越界、是否被投毒 |
数据探针 + DLP |
|
供应链 |
模型文件、依赖包、镜像、MCP 服务、规则文件 |
来源是否可信、是否被篡改 |
供应链探针 + CI 集成 |
1.4 成熟度:四级台阶与每级的停滞点
绝大多数 AI 安全项目死在 L1 到 L2 之间——不是技术不够,而是“看得见”之后没有下一步动作,台账变成一张没人维护的 Excel。把成熟度分级的意义,是让每一级都有明确的退出条件。
表 1-3AI-SPM 能力成熟度四级模型
|
级别 |
能力特征 |
标志性指标 |
常见停滞原因 |
|
L1 可见 |
资产台账、影子 AI 发现、调用日志 |
台账覆盖率 ≥ 90%,影子 AI 识别率 ≥ 80% |
只做网关,端内与东西向是盲区;台账无人认领 |
|
L2 可判 |
检测规则、行为基线、风险评分 |
误报率 ≤ 30%,MTTD ≤ 15 分钟 |
规则堆叠导致告警洪水,分析师弃用 |
|
L3 可管 |
分级处置、SOAR 联动、工单闭环 |
自动处置率 ≥ 60%,业务中断 ≤ 5 分钟/次 |
不敢阻断;处置权限未预先授权 |
|
L4 可证 |
合规证据自动生成、敞口指数、回归验证 |
审计准备时间下降 70%,回归通过率 ≥ 95% |
证据链不完整,无法回溯到原始会话 |
|
一个反直觉的判断 L2 的“误报率 ≤ 30%”不是技术指标,而是组织指标。当误报率超过 30%,值班工程师会开始“看标题不看内容”,检测系统事实上失效。所以提升精度的投入,应该优先于提升覆盖面的投入——覆盖再全,没人看等于零。 |
二、总体架构:遥测节点与平台的分工
2.1 三条设计原则
架构不是模块的堆叠,而是一组约束的固化。这套架构遵循三条硬约束,每一条都对应一个真实世界的失败案例。
原则一:端侧不做深度分析。 把模型推理、语义判定放到端侧,会同时踩三个坑——算力争抢(用户抱怨电脑变卡)、隐私冲突(原始会话数据不能离域)、模型维护(端侧模型版本无法统一)。端侧只做三件事:采集、归一、脱敏。判定一律上移。
原则二:平台不囤原始数据。 平台保存的是“证据片段”而不是“全量日志”:命中规则前后的若干轮对话、触发动作的完整调用参数、当时的策略版本与模型指纹。全量留存既过不了数据合规,也撑不住成本。
原则三:探针不绑定单一位置。 串接部署能阻断,但改造量大、故障域大;旁路部署能观测,但削弱处置能力。所以每一类探针都必须支持“串接 / 旁路 / 端内”三种形态中的至少两种,并允许能力降级——降级不是妥协,而是让方案能真正落地的前提。
2.2 四层的职责与交付物
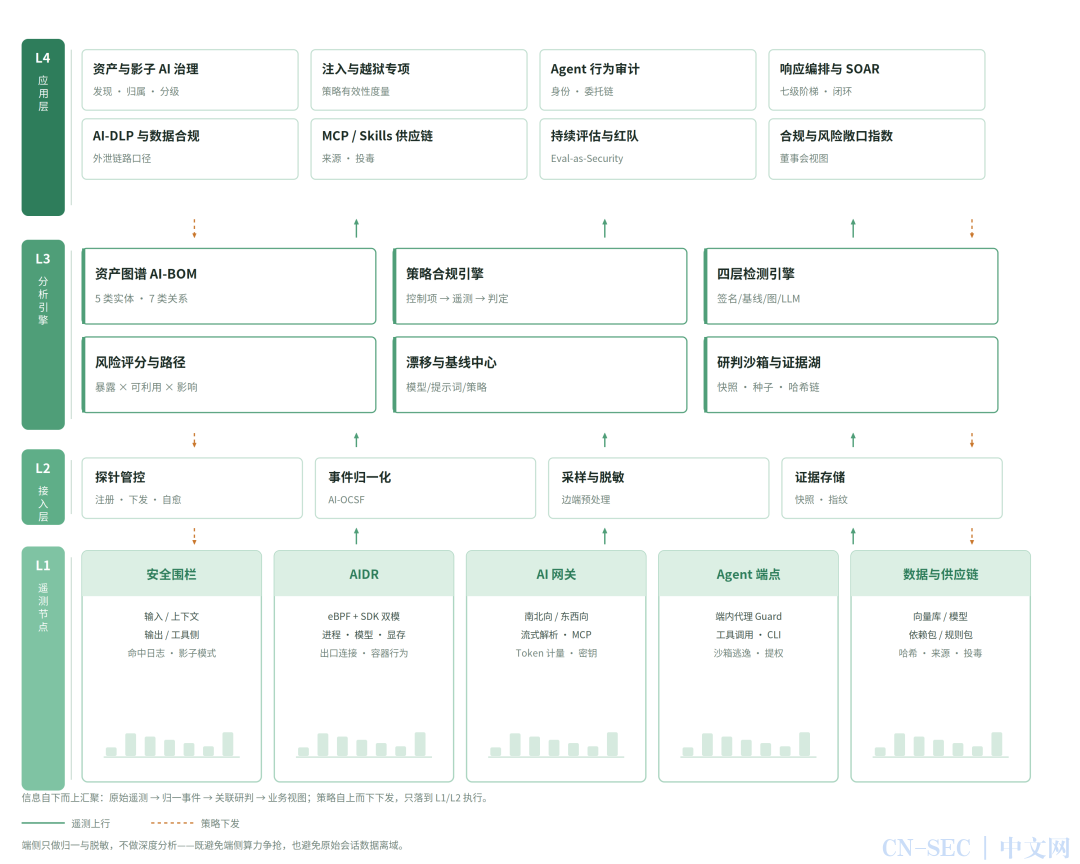
图 2-1AI-SPM 四层参考架构:L1 只采集,L2 只归一,L3 承担全部判断,L4 面向业务角色
四层的划分标准不是“功能多少”,而是变化频率:越往下变得越勤(探针版本、采集字段),越往上变得越慢(业务视图、报表口径)。按这个标准切分,任何一层的升级都不需要改动其他层,这也是这套架构能在不同行业复用的原因。
表 2-1四层架构的职责划分
|
层 |
职责 |
关键设计 |
交付物 |
|
L1 遥测节点 |
采集原始信号,做边端预处理 |
统一探针镜像,按角色裁剪;离线缓存与断点续传 |
原始事件、资源指标、会话片段 |
|
L2 接入层 |
归一、采样、脱敏、证据落盘 |
AI-OCSF 扩展模型;分级采样;字段级脱敏 |
标准事件、证据包 |
|
L3 分析引擎 |
资产建图、策略判定、检测、评分、路径分析 |
图存储 + 流式规则 + 批处理基线 |
风险项、攻击链、评分 |
|
L4 业务应用 |
面向角色的视图与动作 |
按角色出界面:CISO 看敞口、分析师看告警、业务看影响 |
工单、报表、处置指令 |
2.3 部署拓扑:五个可观测环节
AI 请求从人到模型,会经过五个可以下钩子的位置。每个位置的观测价值不同,缺失任何一个都会留下结构性盲区。实践中最常见的错误是只做第①个环节(网关),结果“影子 AI 看得见、Agent 越权看不见”。
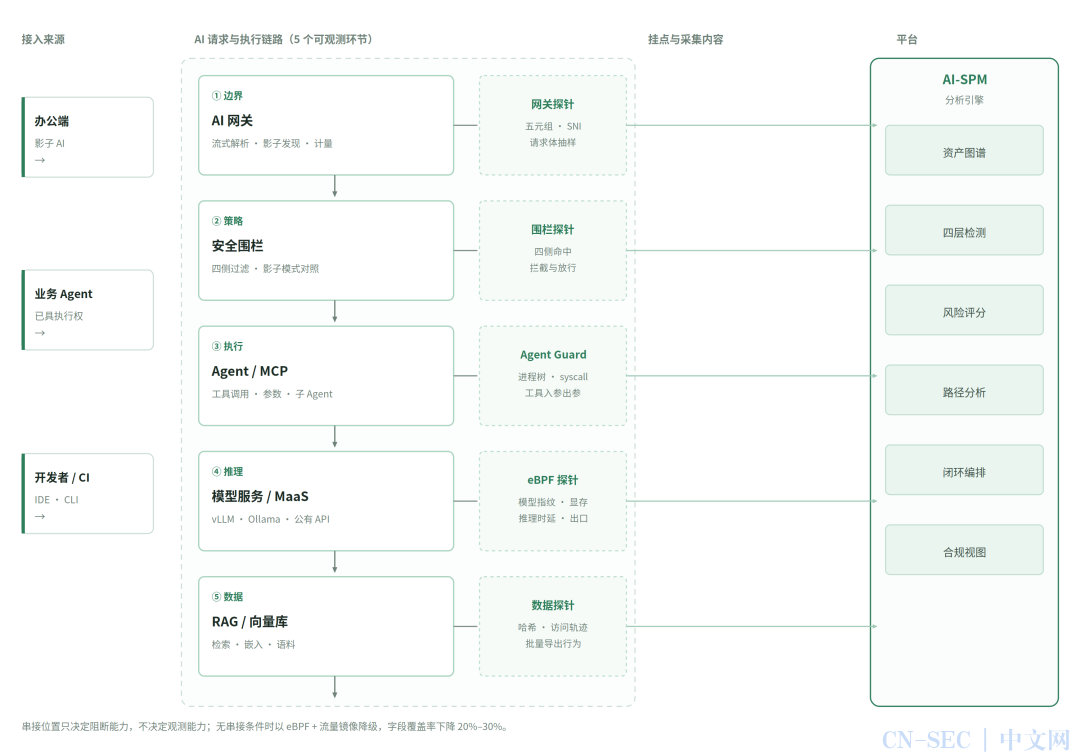
图 2-2五个可观测环节与对应探针:串接位置决定阻断能力,观测位置决定可见性
表 2-2五个环节的观测价值与缺失风险
|
环节 |
观测价值 |
缺失后的盲区 |
部署建议 |
|
① 边界(网关) |
影子 AI、外部模型调用、Token 成本、密钥外发 |
员工私接的公共模型完全不可见 |
优先串接,至少旁路镜像 |
|
② 策略(围栏) |
策略命中、拦截效果、绕过尝试 |
无法判断围栏是否真的有效 |
影子模式并行,逐步转串接 |
|
③ 执行(Agent/MCP) |
工具调用、参数构造、子 Agent 派生 |
越权操作与横向移动完全不可见 |
端内代理 + eBPF 双模 |
|
④ 推理(模型服务) |
本地模型私搭、显存异常、推理时延 |
私有化部署的模型成为法外之地 |
eBPF 为主,SDK Hook 补充 |
|
⑤ 数据(RAG/向量库) |
检索范围、批量导出、投毒痕迹 |
数据外泄与知识库污染无法定位 |
数据库审计 + 文件访问监控 |
2.4 统一事件模型:为什么必须有 subject 和 object
如果每个探针各自定义字段,平台侧就只能做“字符串匹配”,做不了图分析。所以事件模型的第一条要求不是字段多,而是每条事件都必须能回答三个问题:谁发起的(subject)、对什么做的(object)、在什么上下文里(context)。缺少 subject 或 object 的事件,在图上就是孤立点,对攻击链分析毫无价值。
我们在 OCSF 的基类上做了一层 AI 扩展,核心字段 19 个,分为四组。完整定义见附录 B,这里只强调三个容易被忽略的字段:
· session_id:一次人机交互的全局标识,跨网关、围栏、Agent、模型服务保持一致。没有它,多步攻击链无法拼接。
· policy_version:判定时所生效的策略版本号。复盘时最常见的困境是“当时为什么放行”,没有这个字段就永远答不上来。
· model_fingerprint:模型文件哈希 + 推理框架版本 + 关键参数(温度、最大 token)。同一句提示词在不同模型上的行为差异,足以改变判定结论。
|
工程经验:字段设计的“3 秒原则” 任何一条告警,分析师应该在 3 秒内从事件字段里判断出“这是谁的会话、碰了什么数据、当时用的哪版策略”。如果做不到,说明字段设计失败——再强的检测引擎也会被“上下文缺失”拖死。 |
2.5 容量与成本模型
AI-SPM 的成本结构和传统安全设备不同:它的瓶颈不在带宽,而在事件基数与存储保留期。一个 1000 人规模、日均 8 万次模型调用的企业,按下面的口径估算(经验值):
表 2-31000 人规模企业的容量估算(经验值)
|
项目 |
口径 |
估算值 |
说明 |
|
日均调用量 |
8 万次/日,峰值 6 QPS |
— |
含员工办公、业务应用、Agent 自动调用 |
|
单次调用事件数 |
网关 1 + 围栏 2 + 工具 3(均值) |
约 6 条 |
Agent 场景可达 20 条以上 |
|
原始事件量 |
8 万 × 6 |
48 万条/日 |
未压缩,约 1.2 GB/日 |
|
采样策略 |
正常流量 1:40,命中与异常全采 |
约 1.5 万条/日入库 |
采样只针对“无判定价值”的正常流量 |
|
证据存储 |
仅存命中前后各 3 轮会话 |
约 8 GB/月 |
90 天滚动,冷热分层 |
|
平台算力 |
4 核 16G × 3 节点 |
可支撑 10 万次/日 |
图查询是主要开销,需独立部署 |
这里有一个容易踩的坑:采样率不能按固定比例设。攻击流量往往藏在“看起来正常”的调用里,如果统一按 1:40 采样,恰好会把关键的那一条丢掉。正确做法是按“判定结果”分层——已命中规则的、首次出现的主体、首次出现的工具组合,一律全采;只有长期稳定、无任何标签的流量才采样。
三、遥测节点:五类探针的采集口径
探针的价值不取决于“能采多少”,而取决于“采的东西能不能支撑判定”。下面每一类探针,我们只讨论三件事:钩在哪、采什么、能回答什么问题。
3.1 安全围栏探针:从“拦截器”到“策略有效性度量器”
围栏是 AI 安全投入最容易被看见、也最容易失效的一环。失效的方式很一致:上线时拦住了 200 个越狱样本,汇报里写“拦截率 99%”,三个月后没人知道它还在不在工作,也没人知道攻击者早就换了绕过手法。问题不在围栏本身,在于没有度量它的探针。
围栏探针的钩子必须打在四个侧面,缺一个就会留下结构性绕过面:
表 3-1围栏探针的四侧观测点
|
侧面 |
观测点 |
典型信号 |
常见绕过 |
|
输入侧 |
用户消息、上传文件、URL 内容 |
越狱模板、角色扮演、多语言混杂、Base64/Unicode 变形 |
把恶意指令拆到多轮对话 |
|
上下文侧 |
系统提示词、检索片段、工具返回值 |
间接注入(检索内容里藏指令)、工具返回污染 |
污染知识库而非直接提问 |
|
输出侧 |
模型响应、流式分片 |
敏感信息、恶意代码、有害内容、系统提示词泄露 |
分段输出绕过单次检测 |
|
工具调用侧 |
函数名、参数、返回结果 |
越权工具、参数注入、路径穿越、SSRF |
用合法工具做非法操作 |
真正让围栏“可度量”的,是影子模式(Shadow Mode):探针把流量复制一份给围栏,围栏照常判定,但结果只记录、不阻断。这样能得到一张二维对照表,而这张表才是围栏治理的起点。
表 3-2影子模式产出的四象限对照表
|
围栏判黑 |
围栏判白 |
|
|
业务侧已放行 |
漏拦:围栏认为有问题但没拦住——策略未生效或被旁路 |
正常放行(需抽样确认) |
|
业务侧已阻断 |
正常拦截 |
误拦:围栏认为没事但业务被拦——通常是策略过严 |
持续跑两周,四个格子的数量会暴露所有问题:右上角大,说明围栏形同虚设;左下角大,说明误拦严重、业务在投诉;左上角大,说明策略配置了但没生效(常见于网关绕过了围栏、或流式响应没走检测);右下角大,才是健康状态。
在此之上定义五个可量化指标,构成围栏的“体检表”:
表 3-3围栏有效性的五个度量指标
|
指标 |
定义 |
计算口径 |
目标值(经验) |
|
拦截率 |
判黑并成功阻断的比例 |
阻断数 / 判黑数 |
≥ 99%(针对判黑样本) |
|
误拦率 |
正常请求被判黑的比例 |
人工抽样确认的误拦 / 总请求 |
≤ 0.5% |
|
绕过成功率 |
红队样本中未被拦截的比例 |
绕过样本 / 投放样本 |
≤ 5%,且逐月下降 |
|
覆盖率 |
经过围栏的 AI 流量占比 |
围栏流量 / 网关总流量 |
≥ 95% |
|
策略漂移度 |
策略版本变化导致的命中分布偏移 |
JS 散度(相邻两版) |
突变需人工复核 |
|
这一节的结论,可能和直觉相反 围栏的 KPI 不应该是“拦截了多少次”。拦截次数越高的围栏,往往越可能是误拦严重的那一个。真正应该看的,是影子模式下“判黑且放过”的比例——它衡量的是“你以为拦住了、其实没有”的那部分风险,而这部分风险,在传统报表里是完全不可见的。 |
3.2 AIDR 探针:把 AI 运行时变成可观测对象
AIDR(AI Detection and Response)探针解决的是“主机上到底跑着什么 AI”这个问题。传统 HIDS 看见的是 python 进程、看见的是 8000 端口监听,但它不知道这个进程加载了 4GB 的 gguf 文件、正在对外提供 OpenAI 兼容接口。
采集方式分两条腿,互为补充:
· eBPF 内核态:挂钩 execve(进程启动)、openat(模型文件打开)、connect(外联)、mmap(大文件映射)、以及 GPU 相关的 ioctl。优点是全量、无法被用户态绕过;缺点是需要内核版本支持,语义需要推断。
· SDK / 库 Hook:在 transformers、vllm、ollama、langchain 等库的入口处埋点,直接拿到模型名、推理参数、工具调用结构。优点是语义精确;缺点是可被绕过(静态编译、换实现)。
两条腿合起来,才能回答下面这些问题——而这些问题的答案,恰恰是“AI 资产台账”里最难补齐的部分:
表 3-4AIDR 的典型推断链
|
观测现象 |
推断结论 |
风险含义 |
|
python 进程 mmap 一个 .gguf / .safetensors |
本地加载了大模型 |
未授权模型私搭,可能绕过网关与围栏 |
|
监听 0.0.0.0:11434(Ollama 默认端口) |
对外提供模型服务 |
暴露面扩大,可能被外部白嫖或作为跳板 |
|
进程读取 ~/.aws/credentials 后发起 HTTPS 外联 |
凭据读取 + 外发 |
典型窃密链,需立即处置 |
|
高频调用 embedding 接口 + 大量文件读取 |
批量向量化 |
知识库被整体导出,属于数据外泄前兆 |
|
Agent 子进程执行 curl / wget / nc |
工具滥用或沙箱逃逸尝试 |
Agent 被诱导执行系统命令 |
一个必须承认的限制:eBPF 能看见“进程做了什么”,但看不见“模型想了什么”。所以 AIDR 的定位是行为侧的最后一道观测网,语义层的判断必须交给围栏和 LLM 研判。两者不可互相替代。
3.3 AI 网关探针:流式解析是门槛
网关探针看起来是最成熟的一类,实际上有三个工程难点,决定了它是“能用”还是“好用”:
难点一:流式响应(SSE)的拼接。 模型输出是按 token 分片返回的,一条恶意内容可能横跨 20 个 chunk。如果按 chunk 独立检测,几乎必然漏判。正确做法是维护一个滑动窗口缓冲区,按标点或固定长度切分后再送检,同时保留“已放行内容”的状态——因为一旦前 500 字已经推给用户,后面再拦截也来不及了。这也意味着:流式场景下的输出检测,天然是“延迟检测”,必须配合输入侧与工具侧的强管控才成立。
难点二:影子 AI 的识别。 员工用浏览器访问 chat.openai.com,流量是 TLS 加密的。可用的信号有三层:SNI 与证书指纹(最直接,但可被域前置绕过)、JA3/JA4 指纹(识别客户端栈)、以及请求行为特征(POST 体大小、响应时序、心跳间隔)。三层叠加才能把误报压下来。
难点三:MCP 与工具调用的解码。 MCP 走 JSON-RPC over stdio 或 SSE,工具名和参数在协议体里。网关需要解析出“调用了哪个工具、参数是什么”,才能做工具白名单与参数校验。这也是当前最容易出问题的地方——因为 MCP 服务端常常部署在内网,网关根本看不见,只能靠端内探针补。
3.4 Agent 端点探针:把“能力边界”变成可执行约束
Agent 端点是当前攻防最不对称的地方:Agent 有执行能力(读文件、发请求、调工具),但它的“意图”来自一个可能被污染的上下文。端点探针要做的,是把“它能做什么”从一句系统提示词,变成一组运行时可见、可拦的约束。
表 3-5Agent 端点探针的五个观测维度
|
观测维度 |
采集内容 |
判定逻辑 |
处置动作 |
|
工具调用序列 |
工具名、参数、返回、耗时 |
序列偏离基线 / 出现高危工具组合 |
中断会话、吊销工具授权 |
|
命令执行 |
子进程命令行、父进程链 |
出现 curl/wget/nc/base64 -d 等模式 |
阻断进程、隔离端点 |
|
文件访问 |
路径、读写量、访问频次 |
越出工作目录 / 批量读取凭据文件 |
只读挂载、拒绝访问 |
|
网络出口 |
目标域名、端口、字节数 |
非白名单外联 / 大流量上行 |
DNS 拦截、限速 |
|
身份与委托 |
Agent 令牌、被委托的用户身份 |
权限超出声明范围 / 委托链异常 |
回收令牌、降权 |
这里有一个设计要点:能力边界必须在工具层实施,而不是在提示词层声明。“你不可以删除文件”是一句建议;“delete_file 工具对该 Agent 不可见”才是一条约束。端点探针要做的,是持续验证后者是否真的成立——包括发现“声明不可见、实际可调用”的能力漂移。
3.5 数据与供应链探针:最容易被忽略的一类
AI 供应链的攻击面比传统软件供应链更宽,因为它多了两类传统安全不熟悉的物件:模型文件与规则文件。
· 模型文件:pickle 反序列化可以直接执行代码(这也是大量模型加载库的历史漏洞来源);模型可能被植入后门触发器;许可证可能禁止商用。探针需要采集哈希、来源、格式、许可证四要素。
· 规则文件:Copilot 的 .github/copilot-instructions.md、Cursor 的 .cursorrules 这类文件会被模型当成高优先级指令读取。攻击者只要往仓库里提交一个带隐藏指令的规则文件,就能影响所有拉取该仓库的开发者——这类攻击 2025 年已被公开验证。
· 依赖包:AI 应用的依赖树极深(一个 langchain 应用动辄 300+ 包),而针对 AI 开发者的供应链攻击已经出现(窃取 CLI 凭据、篡改构建产物)。
3.6 覆盖矩阵:没有一种探针能覆盖全部风险
下面这张矩阵是整套架构的“体检表”。它的用途不是展示能力,而是暴露缺口——任何一行出现“—”,就意味着这类风险在该位置不可观测,必须靠其他手段补偿。
表 3-6探测能力覆盖矩阵(● 直接覆盖 ○ 间接可见 — 不可见)
|
风险类型 |
围栏 |
AIDR |
网关 |
Agent 端点 |
数据/供应链 |
|
提示注入 / 越狱 |
● |
○ |
● |
○ |
— |
|
影子 AI / 未授权模型 |
— |
● |
● |
○ |
○ |
|
Agent 越权 / 工具滥用 |
○ |
● |
○ |
● |
— |
|
敏感数据外泄 |
● |
○ |
● |
○ |
● |
|
模型 / 供应链投毒 |
— |
○ |
— |
— |
● |
|
知识库污染 / 检索投毒 |
○ |
— |
— |
— |
● |
|
成本攻击 / 资源耗尽 |
— |
● |
● |
○ |
— |
|
合规证据缺失 |
● |
○ |
● |
● |
● |
读这张表的方式:沿着列看,找“—”最多的一列,那就是最薄弱的探针;沿着行看,找“●”最少的行,那就是最需要靠流程补偿的风险。比如“知识库污染”这一行只有数据探针能覆盖,说明这类风险的发现强依赖于数据侧的建设程度,不能指望网关或围栏。
四、分析引擎:从事件到判断
引擎层要做四件事:把事件连成资产、把资产放进合规框架、把异常判成风险、把风险排成优先级。四件事的顺序不能颠倒——没有资产图谱,检测结果就无法归因;没有合规映射,风险就无法向管理层解释。
4.1 资产图谱:AI-BOM 的真正用途
AI-BOM(AI 物料清单)常被做成一张静态表格,这是对它的浪费。它的价值在于关系:同一个模型被哪些 Agent 使用、这些 Agent 又挂了哪些工具、这些工具能碰哪些数据。只有这张图存在,“影响面”才是可计算的,而不是靠人拍脑袋。
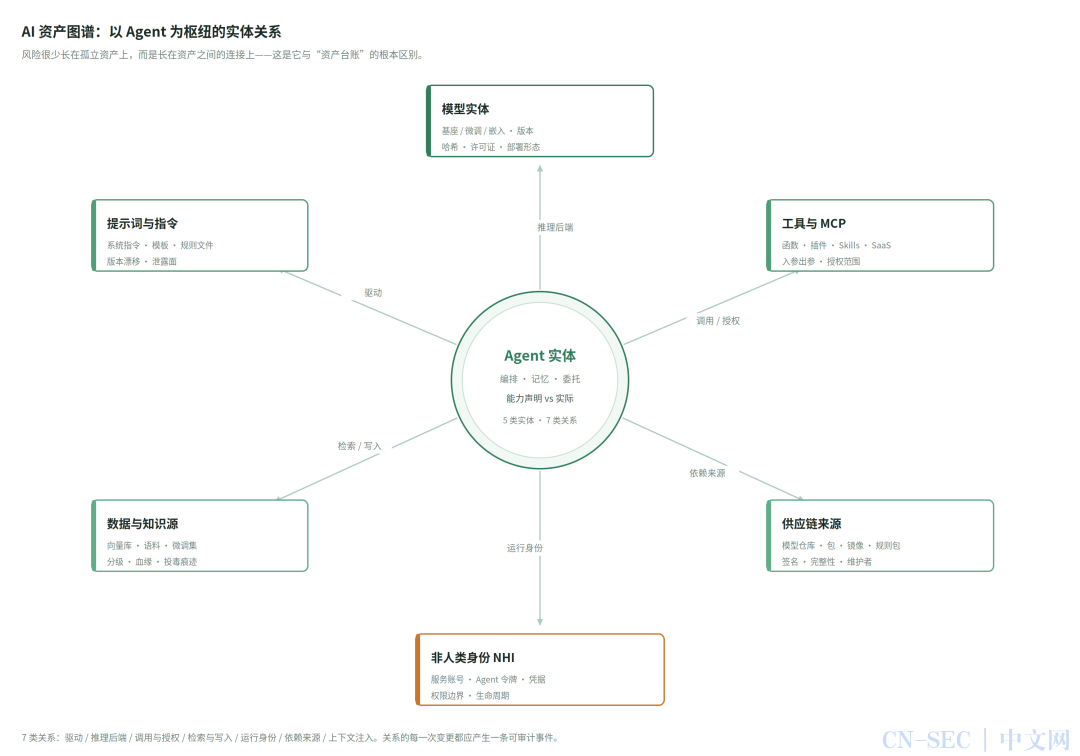
图 4-1以 Agent 为枢纽的资产关系图:五类实体、七类关系
图谱落地时有三个必须做对的设计:
①关系必须带时间戳。一条“Agent 调用 MCP 服务”的边,不是永久事实,而是某段时间内的事实。没有时间维度的图谱,无法回答“这次变更之前是什么样”。
②实体必须能合并同一性。同一个模型在网关日志里叫 gpt-4o,在端内叫 gpt-4o-2024-11-20,在资产系统里叫 OpenAI-GPT4o-Prod。没有实体对齐,图谱就是一盘散沙。
③边要有置信度。通过流量推断出的“调用关系”是推断,通过配置读取到的“授权关系”是事实。两者混在一起,会让影响面分析严重失真。
4.2 策略合规引擎:把标准编译成检测项
合规映射的常见做法是“做一个对照表”,然后束之高阁。可用的做法是三段式编译:每一条控制要求,都必须能落到“哪条遥测事件、什么判定逻辑、缺证据时怎么降级”这三段上。落不下去的,说明这条要求当前不可验证,应该明确标注为“流程控制”,而不是假装技术能覆盖。
表 4-1合规要求到检测项的三段式映射
|
控制要求(示例) |
需要的遥测证据 |
判定逻辑 |
不可验证时的降级 |
|
AI 系统须有明确的责任人与用途登记 |
资产图谱中的 owner、purpose 字段 |
存在无 owner 或无 purpose 的资产 → 扣分 |
以 CMDB 工单为准,季度人工核对 |
|
输入内容须经安全过滤 |
围栏探针的输入侧命中日志 + 覆盖率 |
覆盖率 < 95% 或存在判黑未拦 → 不合规 |
以影子模式抽样替代 |
|
模型输出须可追溯 |
会话 ID + 模型指纹 + 策略版本 |
任一缺失 → 证据链不完整 |
归档原始请求摘要 |
|
训练数据须来源合法 |
数据探针的语料来源与许可证记录 |
存在来源不明语料 → 高风险 |
要求业务提供授权证明 |
|
高风险场景须有人工复核 |
处置记录中的确认人字段 |
L6/L7 处置无确认人 → 违规 |
抽查工单 |
这套映射直接对应 NIST AI RMF 的四项功能(GOVERN / MAP / MEASURE / MANAGE)与 ISO/IEC 42001 的管理体系要求,也兼容国内《生成式人工智能服务安全基本要求》中对语料与生成内容的要求。关键不是覆盖了多少条标准,而是每一条“已覆盖”的背后,都有一条真实存在的遥测证据。
4.3 四层检测:让告警数量下降一个数量级
单层检测的死结是:规则严了告警爆炸,规则松了漏报。四层串联的思路是逐层收敛——前两层负责“宽进”,后两层负责“严出”。
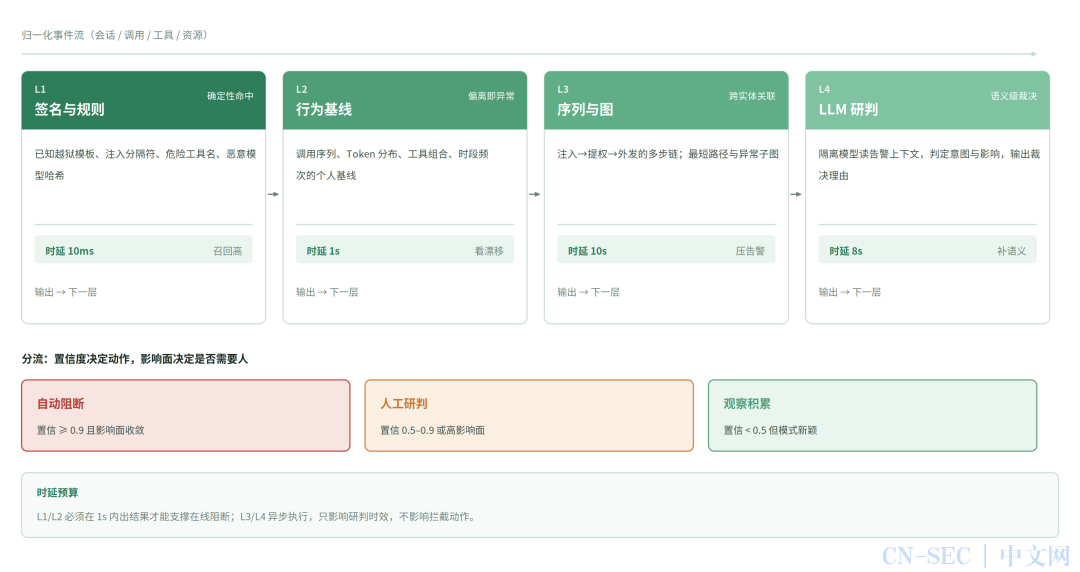
图 4-2四层检测流水线:L1/L2 决定能不能在线阻断,L3/L4 决定研判质量
每一层的定位不同,不能互相替代:
· L1 签名解决“已知的已知”。价值在于快和确定,局限在于对新手法完全无效。
· L2 基线解决“已知的未知”。它能发现“这个 Agent 今天第一次调用删除类工具”,但说不出这是不是攻击。
· L3 图与序列解决“单点看不见的链”。把“读凭据 → 编码 → 外联”三个孤立事件连成一条链,是压缩告警的关键。
· L4 LLM 研判解决“语义层的意图”。它能把“用户在问报销流程”和“用户在套取系统提示词”区分开——但必须给它结构化的输入和明确的判定框架,否则它会编造理由。
|
关于用 LLM 做研判的三条硬约束 ① 隔离:研判模型必须与被监测系统隔离,且不能读取真实敏感数据(用脱敏后的上下文)。 ② 可复现:同一告警包的判定结果应稳定,温度设为 0,并记录模型版本;否则无法用于取证。 ③ 不许它做最终决定:LLM 只输出“判定 + 置信 + 理由”,是否阻断由规则与影响面共同决定。把阻断权交给一个可能被提示注入的模型,是把防线建在流沙上。 |
4.4 风险评分:一个可以争论的公式
风险评分最容易变成玄学。我们的做法是把它写成显式公式,让每一个因子都可追溯、可争论、可调参:
R = (E × X × I) ^ (1/3) × C × T
其中 E 为暴露面(Exposure)、X 为可利用性(Exploitability)、I 为影响(Impact),三者取几何平均以避免单一因子主导;C 为置信度(Confidence,0.5–1.0),T 为时效衰减因子(Time,随未处置时长下降)。几何平均的选择是有意的:只要有一项接近 0,整体风险就应该被压低——因为“极度危险但完全不可达”的东西,优先级确实不该最高。
表 4-2风险评分的五个因子
|
因子 |
取值范围 |
取值依据 |
示例 |
|
E 暴露面 |
1–5 |
可达用户数、是否公网、是否高权限 |
面向全员开放的客服 Agent = 5 |
|
X 可利用性 |
1–5 |
是否需要认证、攻击复杂度、是否有公开 PoC |
存在公开越狱模板 = 4 |
|
I 影响 |
1–5 |
数据敏感级、可执行动作的危害、合规后果 |
可读取客户 PII = 5 |
|
C 置信度 |
0.5–1.0 |
检测层给出的置信度(L1 高、L3 中、L4 校准后) |
多源关联确认 = 0.9 |
|
T 时效 |
0.6–1.0 |
未处置时长超过 24h 开始衰减 |
72h 未处置 = 0.7 |
算例:某客服 Agent 面向全员开放(E=5),存在公开越狱模板(X=4),可读取客户手机号(I=5),多源关联确认(C=0.9),已挂起 48 小时(T=0.85)。
R = (5×4×5)^(1/3) × 0.9 × 0.85 = 4.64 × 0.765 ≈ 3.55(满分 5)——落入“24 小时内必须处置”区间。注意这个分数是可解释的:任何一位评审都可以质疑“为什么 I 取 5”,然后回到数据分级表去核对。这比一个黑箱模型输出的 87.3 分有用得多。
4.5 攻击路径分析:从告警到“这条链能走多远”
单条告警说“检测到一次异常外联”,攻击路径分析要说的是“这个外联来自一个能读客户库的 Agent,它的令牌还能调用三个内部系统,所以这条链的爆炸半径是 12 万条客户记录”。后者才是决策依据。
一条真实感较强的链路(用于说明分析逻辑,非特定事件):
知识库文档(被投毒)→ 检索命中 → 上下文注入 → Agent 选择「发送邮件」工具 → 参数中包含内部数据 → 外发至外部地址 → 网关检测到异常外联
四个孤立的检测点分别只能给出“文档更新”“检索命中”“工具调用”“异常外联”,任何单点都可能是正常业务。只有当图谱把四者连成一条路径,并且路径上的主体、时间、数据流一致时,才能判定为攻击。这就是“平台模式”相对“单点设备”的核心价值——它卖的不是检测能力,是关联能力。
4.6 漂移检测:把“变化”本身当作信号
AI 系统里最危险的不是“一直很危险”,而是“昨天还很正常”。所以引擎需要持续监测四类漂移:
表 4-3四类漂移的检测方法与阈值
|
漂移类型 |
观测对象 |
检测方法 |
告警阈值(经验) |
|
模型漂移 |
同一提示词的输出分布 |
嵌入向量分布的 KL 散度 |
周环比 > 0.15 |
|
提示词漂移 |
系统提示词的哈希与长度 |
版本比对 + 语义差异 |
任何未登记变更 |
|
策略漂移 |
围栏/网关规则的命中分布 |
相邻版本的 JS 散度 |
突变 > 0.3 |
|
能力漂移 |
Agent 实际可调用的工具集合 |
声明清单 vs 运行时观测 |
出现任一未声明工具 |
这四类里,能力漂移最值得投入。因为它对应的是最危险的一类情况:Agent 的说明文档写着“只能查询订单”,但运行时它实际调用了退款接口。这种偏差要么来自配置错误,要么来自攻击者的权限提升——两者都必须立即处置。
五、业务安全应用:八个落地面
引擎产出的是“判断”,业务需要的是“动作”。中间这层如果设计不好,平台会退化成一个只有安全团队会登录的高级日志系统。八个应用模块的划分标准是使用者角色,而不是功能分类——因为不同角色关心的粒度和时间尺度完全不同。
表 5-1八个业务应用模块与使用者
|
模块 |
主要使用者 |
核心动作 |
输出节奏 |
|
AI 资产与影子 AI 治理 |
AI 安全负责人 |
认领、分级、收敛 |
周 |
|
提示注入与越狱专项 |
安全运营 |
策略调优、红队验证 |
日 |
|
Agent 行为审计 |
安全运营 / 审计 |
会话回溯、越权确认 |
实时 + 月报 |
|
AI-DLP 与数据合规 |
数据安全官 |
外泄确认、脱敏整改 |
日 |
|
模型与 MCP 供应链 |
架构师 / 安全工程 |
准入、扫描、版本锁定 |
版本触发 |
|
持续评估与自动化红队 |
安全研究 |
回归、门禁、评分 |
版本触发 |
|
事件响应与 SOAR |
值班工程师 |
分级处置、工单 |
实时 |
|
合规视图与敞口指数 |
CISO / 董事会 |
决策、资源分配 |
季 |
5.1 场景一:影子 AI 治理——从“发现”到“收敛”
影子 AI 治理失败的项目,几乎都停在“发现”这一步:出了一份报告,列了 47 个外部 AI 服务,然后没有然后了。真正的工作在后面三步:认领、评估、收敛。
认领:把每个发现的 AI 服务绑定到部门与责任人。技术上靠三件事——出口流量的源 IP 归属、SSO 登录日志的账号归属、端内探针的进程归属。三者交叉,能把 80% 的“未知使用者”变成“已知使用者”。剩下 20% 不要强行归因,标记为“共享出口”,避免制造假数据。
评估:不是所有影子 AI 都要封。评估维度是三个问题——数据进去了吗(有没有粘贴客户信息)、结果被用在哪(只是写文案,还是进了生产系统)、服务商条款是否允许(是否用于训练)。三个问题的答案决定处置:允许、限制(仅允许非敏感场景)、封禁。
收敛:给出替代方案比封禁更有效。实践中最有效的做法是“提供合规的等价物”——企业内部署一套同样好用的模型服务,员工自然不会去外面用。纯封禁的结果是流量转向手机热点,彻底失去可见性。
|
一个数字上的判断 影子 AI 的“清零”是不现实的目标。合理的 KPI 是:可见率 ≥ 95%、敏感数据外发事件下降 80%、员工主动申报比例上升。最后这个指标最反直觉,但它最能反映治理是否被接受——当员工愿意主动说“我在用某个工具”,说明你的替代方案是有效的。 |
5.2 场景二:Agent 越权治理——身份、委托与能力
Agent 越权是 2025 年增长最快的一类问题,根源在于身份模型的缺失。一个 Agent 通常用某个服务账号运行,这个账号的权限是“为了让它能工作”而给的,往往是超配的;而 Agent 的行为由上下文决定,上下文又可能被污染。于是形成一条典型链路:污染上下文 → 诱导 Agent 调用高权限工具 → 以服务账号身份完成操作。
治理要落在三个点上:
①身份最小化。每个 Agent 一套独立身份,不用共享服务账号;令牌短时效(建议 ≤ 1 小时)、范围受限(只含它声明的工具);吊销要能秒级生效。
②委托链完整。当 Agent A 调用 Agent B,B 必须知道“真正的发起人是谁”,并在权限判定时使用“发起人权限 ∩ Agent 权限”的交集,而不是 Agent 自己的权限。这条规则能挡掉大部分横向移动。
③能力声明与实际比对。每个 Agent 上线时声明它需要哪些工具,运行时持续比对实际调用集合。出现未声明工具,立即告警——这是发现权限提升最灵敏的信号。
5.3 场景三:AI-DLP——外泄路径变了,检测口径也要变
传统 DLP 盯的是“文件被拷到 U 盘”“邮件带附件出去”。AI 场景下的外泄有三条新路径,传统 DLP 一条都看不见:
· 路径一:粘贴进对话框。员工把客户名单粘进公共模型,问“帮我分析一下”。数据以文本形式出境,不经过任何文件通道。
· 路径二:RAG 检索越界。知识库的权限配置错误,导致某部门的 Agent 检索到了另一部门的文档,并在回答里复述出来。数据没“出去”,但越权了。
· 路径三:模型记忆回吐。微调时混入了敏感样本,模型在后续对话中把训练数据“背”了出来。这类泄露最难发现,因为出口完全合法。
对应的检测口径也要变:从“文件指纹”转向“内容指纹 + 会话上下文”。具体做法是对敏感字段做模糊指纹(如手机号段 + 姓名组合、身份证前六位 + 后四位),在输入侧和输出侧同时匹配,并结合会话的“主体权限”判断是否越权——同一段内容,HR 的 Agent 读到是正常,客服的 Agent 读到就是越权。
5.4 敞口指数:给管理层的一个数
董事会不接受“有 37 个高危漏洞”这种表述,他们要的是“我们的 AI 风险这个季度是升了还是降了”。所以需要一个可比的综合指数。我们的做法是四个分项加权,每个分项都可独立解释:
表 5-2AI 风险敞口指数的四个分项
|
分项 |
含义 |
计算方式 |
权重 |
|
可见性 |
资产与流量的可知程度 |
1 − 未纳管资产占比 |
25% |
|
暴露度 |
高风险资产的占比与严重度 |
Σ(资产风险分 × 权重) / 资产数 |
30% |
|
可控性 |
策略覆盖率与处置及时率 |
0.5×覆盖率 + 0.5×(1 − 超时处置率) |
30% |
|
合规性 |
证据完整度与整改闭环率 |
已闭环项 / 应闭环项 |
15% |
指数本身的价值有限,趋势和归因才是重点。所以每期报告必须回答:指数变化主要由哪个分项驱动、由哪些具体资产驱动。否则它会变成一个没人敢质疑、也没人真相信的数字。
六、闭环:识别、研判、处置、复盘
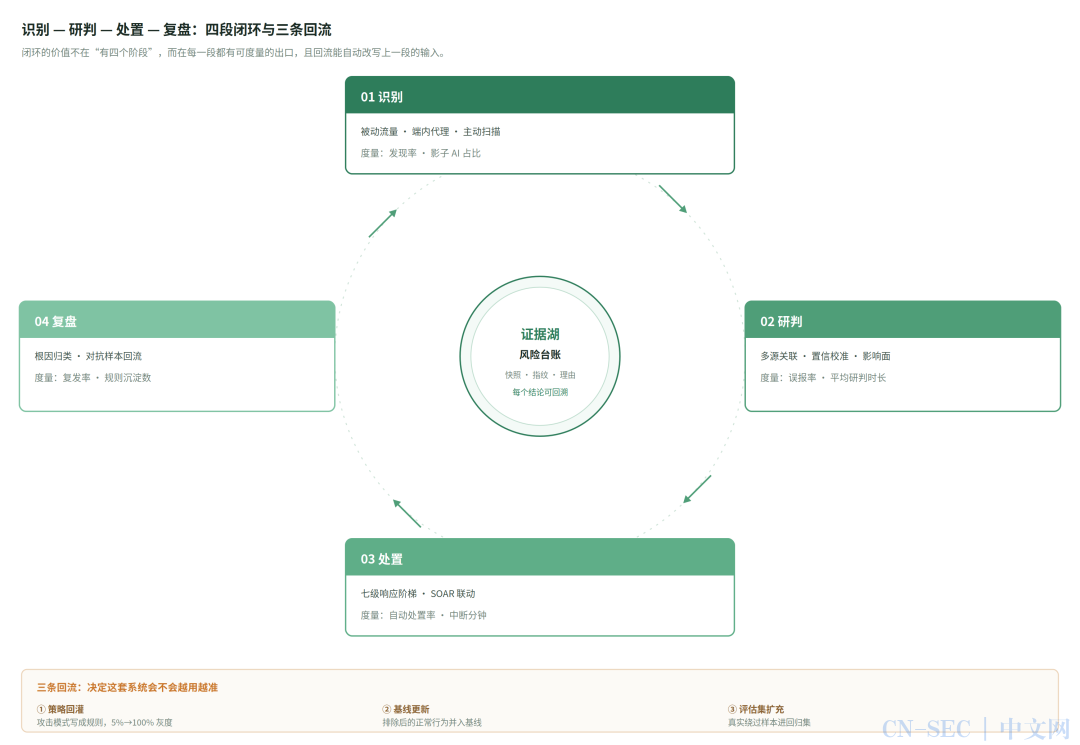
图 6-1四段闭环与三条回流:每一段都有度量出口,回流自动改写上一段的输入
闭环这四个词已经被讲烂了。真正决定成败的,是每一段的出口条件:什么算“识别完成”、什么算“研判充分”、什么算“处置到位”。没有出口条件的闭环,只是一张流程图。
6.1 识别:四种手段与一个诚实的指标
识别手段有四类,成本和覆盖面各不相同,必须组合使用:
表 6-1四类识别手段的覆盖与局限
|
手段 |
覆盖对象 |
优点 |
局限 |
|
被动流量分析 |
经过网关/镜像的所有调用 |
零改造、全量 |
看不见端内与加密隧道 |
|
端内代理与 eBPF |
终端上的 AI 应用与本地模型 |
能看见“不上网关”的那部分 |
需装 agent,有运维成本 |
|
主动扫描 |
网段内的模型服务、MCP 端点 |
发现无人认领的服务 |
可能触发告警,需授权 |
|
CI/CD 集成 |
构建期的依赖、模型、规则文件 |
左移,成本最低 |
看不见运行时行为 |
识别的核心指标只有一个:发现率。它的计算方式必须诚实——用“已知存在的 AI 服务清单”做分母,而不是用“系统已经发现的”做分母。前者需要人工盘点一次作为基准,之后每季度复核。很多项目报“发现率 98%”,其实是拿自己的结果除以自己,毫无意义。
6.2 研判:三级分流与置信度校准
研判的目标不是“判得准”,而是“把有限的人力放在最需要人的地方”。所以设计成三级分流:
表 6-2三级研判分流
|
级别 |
执行者 |
输入 |
输出 |
适用条件 |
|
一级:机器判定 |
规则引擎 |
命中标签 + 资产上下文 |
风险项(含置信度) |
签名命中、基线偏离显著 |
|
二级:引擎关联 |
图分析 + 评分 |
实体关系 + 历史行为 |
攻击链 + 影响面 + 优先级 |
多事件共现、跨实体 |
|
三级:人工研判 |
分析师 |
告警包(会话片段 + 证据) |
确认 / 排除 / 升级 |
置信 0.5–0.9 或高影响面 |
置信度不能拍脑袋。可用做法是把三个信号加权:检测层原始置信(规则强度或模型输出)、证据完整度(相关字段缺失多少)、历史准确率(同类告警过去 30 天的确认率)。三个都高,才进自动处置;任何一项低,就进人工队列。
误报抑制是研判环节最实际的工作,三条经验:
· 同源聚合:同一主体、同一模式、10 分钟内的重复告警合并为一条,避免“一个越狱模板刷 200 条告警”。
· 白名单要带条件:不是“这个 IP 永远放行”,而是“这个 IP 在工作时间、访问这个模型、不含敏感数据时放行”。无条件白名单是误报治理里最大的技术债。
· 排除要有理由码:分析师点“误报”时必须选原因(业务正常 / 测试流量 / 策略过严 / 数据错误)。没有理由码的排除,无法回流成规则优化。
6.3 处置:七级阶梯与“敢不敢拦”的问题
处置环节最大的障碍不是技术,是心理。分析师知道该拦,但不敢拦——因为拦了业务就断,断了就要写事故报告。解法是把“拦”拆成七级,让每一级都有明确的业务代价和授权人,分析师只需要判断“该走到哪一级”。
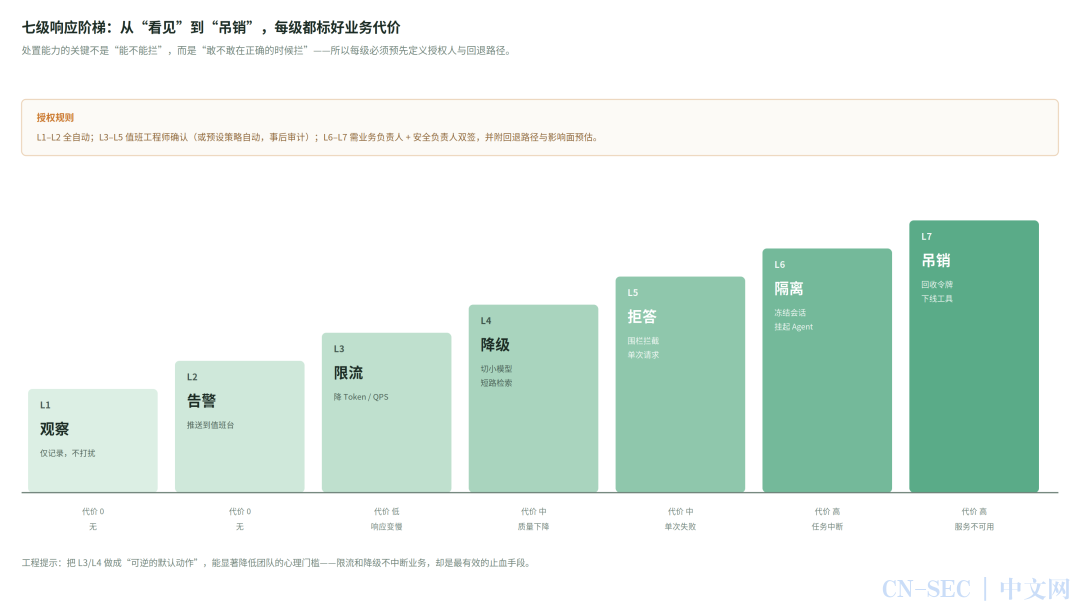
图 6-2七级响应阶梯:级别越高,阻断力越强,业务代价越大,授权要求也越高
阶梯的设计有两个要点:
一是保证前三级“可逆且无感”。观察、告警、限流,这三级的业务影响接近于零,应该做成全自动,让系统在没有人的时候也能“减速”。很多团队跳过这三級直接上阻断,结果第一次误拦就导致项目停摆。
二是把“降级”作为主力手段。切小模型、短路检索、关闭联网工具——这些动作能立刻切断攻击链的关键环节,同时业务还能跑(质量下降但可用)。实践中最有效的止损往往不是“拒答”,而是“降级”。
表 6-3处置级别的选择矩阵
|
场景特征 |
建议起始级别 |
理由 |
|
高置信 + 低影响面 |
L5 拒答 |
单次请求失败,用户重试即可 |
|
高置信 + 高影响面(如批量导出) |
L6 隔离 |
必须立刻挂起,避免持续外泄 |
|
中置信 + 高影响面 |
L3 限流 + 人工 |
先减速争取时间,不贸然中断 |
|
低置信 + 新模式 |
L2 告警 + 观察 |
可能是新型攻击,先积累样本 |
|
凭据泄露已确认 |
L7 吊销 |
令牌一旦泄露,唯一有效动作是吊销 |
6.4 取证:非确定性系统怎么固定证据
AI 事件取证有个天然困境:你无法“重放”一次攻击。同一个提示词再跑一次,模型可能给出完全不同的回答。所以证据链的构造方式必须改变——从“记录输入输出”变成“记录能证明当时状态的一切”。
表 6-4AI 事件取证的六类要素
|
证据要素 |
具体内容 |
作用 |
|
会话快照 |
命中前后各 3 轮的完整消息(含角色、时间戳) |
还原攻击者如何一步步逼近目标 |
|
模型指纹 |
模型名 + 权重哈希 + 推理框架版本 + 温度等参数 |
证明当时的模型状态,排除“换了模型所以结果不同” |
|
策略版本 |
判定时生效的围栏/网关规则版本号与内容哈希 |
证明“当时为什么放行” |
|
检索证据 |
命中的文档 ID、分片内容、相似度分数 |
定位投毒源与污染范围 |
|
工具调用参数 |
完整入参、返回值、执行时长 |
证明越权动作的实际效果 |
|
哈希链 |
上述证据的哈希按时间串联,写入不可篡改存储 |
防篡改,满足审计要求 |
这里有一个常被忽略的细节:采样种子。如果检测环节用了随机采样或随机扰动,必须记录种子,否则连“当时看到了什么”都无法复现。这属于工程细节,但在监管问询时往往是致命的。
6.5 复盘:三条回流与一个反模式
复盘不是写报告,是把一次事件变成三条可执行的变更:
表 6-5复盘的三条回流路径
|
回流 |
具体动作 |
验收标准 |
|
策略回灌 |
把确认的攻击模式写成围栏/网关规则,按 5%→25%→100% 灰度 |
影子模式下新规则命中准确率 ≥ 90% |
|
基线更新 |
把排除后的正常行为并入基线,降低同类误报 |
同类告警量下降 ≥ 50% |
|
评估集扩充 |
把真实绕过样本加入回归集,下次模型/策略升级自动验证 |
回归集覆盖全部已发生的事件类型 |
反模式很统一:把复盘做成“事件说明”。写清楚“什么时候发生了什么、谁处理的、已闭环”,然后归档。这类报告除了应付检查没有任何价值——因为它没有改变系统的任何参数。判断复盘是否有效的标准很简单:下个季度,同类事件的发生次数有没有下降。
6.6 闭环的度量:三个时间指标的正确算法
表 6-6三个时间指标的口径纠偏
|
指标 |
定义 |
常见错误算法 |
正确算法 |
|
MTTD(发现时长) |
从攻击行为发生到系统产生告警 |
从告警产生算起 |
从首个相关遥测事件的时间戳算起 |
|
MTTA(响应时长) |
从告警到有人开始处理 |
从告警创建算起(含排队) |
从首次人工动作(认领/评论)算起 |
|
MTTR(处置时长) |
从开始处理到风险消除 |
以工单关闭为准 |
以“验证性遥测不再出现该行为”为准 |
这三个指标最大的问题是容易被优化成数字游戏:把 MTTD 算成“从告警产生”,数字立刻好看一半;把 MTTR 算成“工单关闭”,只要点一下关闭就能“降低”30%。所以必须在制度上固定口径,并且定期用真实事件回溯校验——否则整套度量会退化成自欺欺人。
七、风险图谱:已显现与潜在
这一章把风险分成两组:一组是已经发生过、有公开证据的;另一组是结构上必然、但尚未大规模爆发的。后者对架构设计更重要——因为防御体系应该按“将会发生什么”来建,而不是按“已经发生了什么”来补。
7.1 已显现的十类风险
表 7-1已显现的十类 AI 风险
|
编号 |
风险 |
机理 |
公开证据 / 参考 |
影响 |
|
R1 |
间接提示注入 |
恶意指令藏在检索文档、网页、邮件里,被模型当作指令执行 |
OWASP LLM01;多起 Copilot 类产品验证 |
工具误用、数据外泄 |
|
R2 |
Agent 越权与工具滥用 |
被污染的上下文诱导 Agent 调用高权限工具 |
OWASP Agentic Top 10;MCP 工具投毒研究 |
横向移动、权限提升 |
|
R3 |
敏感数据外泄 |
零点击场景下,模型自动检索并外发内部数据 |
CVE-2025-32711(M365 Copilot EchoLeak) |
数据泄露、监管处罚 |
|
R4 |
影子 AI |
员工私接外部模型,绕过企业管控 |
普遍现象,各行业调研一致 |
数据出境、合规风险 |
|
R5 |
模型 / MCP 供应链 |
组件漏洞、恶意工具描述、恶意模型文件 |
CVE-2025-49596、CVE-2025-3248、CVE-2024-37032 |
RCE、内网渗透 |
|
R6 |
训练与微调数据污染 |
在语料中植入触发器,形成后门行为 |
学术界已充分验证,工业界案例少见 |
定向错误输出、后门 |
|
R7 |
围栏绕过 |
编码变形、多语言、分段投递、角色嵌套 |
红队实践普遍存在 |
管控失效 |
|
R8 |
上下文与记忆投毒 |
污染长期记忆,影响后续所有会话 |
Agent 记忆机制相关研究 |
持久化控制 |
|
R9 |
无上限消耗 |
诱导模型生成超长内容或无限循环调用 |
MITRE ATLAS 成本耗尽类技术 |
成本激增、服务不可用 |
|
R10 |
输出处置不当 |
模型输出被直接拼进 SQL/Shell/HTML |
CVE-2024-5565(Vanna.AI 注入致 RCE) |
RCE、注入攻击 |
7.2 尚未爆发但结构性必然的八类风险
下面这些风险目前案例不多,但它们的发生条件已经齐备。判断依据是:只要三个前提存在,攻击就会发生——有经济利益、有可复现的手法、有足够大的攻击面。
表 7-2潜在风险的发生条件与早期信号
|
编号 |
潜在风险 |
为什么现在还没爆发 |
触发条件 |
早期信号 |
|
P1 |
委托链污染 |
多 Agent 协作尚未大规模上生产 |
A2A 协议普及、子 Agent 成为常态 |
出现“发起人身份丢失”的调用日志 |
|
P2 |
多智能体共谋 |
缺乏真实的多 Agent 经济场景 |
Agent 之间出现资源交易或议价 |
Agent 间出现非预期的通信模式 |
|
P3 |
持久记忆投毒 |
长期记忆多处于试验阶段 |
记忆跨会话共享、且无写入校验 |
某主体的历史记忆出现异常条目 |
|
P4 |
评测集污染 |
评测尚未成为准入硬门槛 |
评测结果与预算/资质挂钩 |
评测分数异常高但线上事件不降 |
|
P5 |
围栏自身被攻击 |
对抗样本迁移成本仍较高 |
围栏模型公开可探测、可查询 |
出现针对判定边界的探测性请求 |
|
P6 |
A2A 协议层攻击 |
协议标准尚未定型 |
A2A 成为主流集成方式 |
出现伪造的 Agent 卡片或能力声明 |
|
P7 |
模型窃取与蒸馏 |
多数模型价值尚未被充分变现 |
模型成为核心资产、API 可批量查询 |
异常高频、覆盖输入空间的查询 |
|
P8 |
合规证据伪造 |
监管尚未要求机器可读证据 |
证据链成为审计要点 |
日志时间戳与实际行为不一致 |
这张表最有用的列是“早期信号”。它把前瞻性风险转成了可观测指标——比如 P1 的早期信号是“调用日志里发起人字段为空”,这是一个今天就能加进检测规则的判断,不需要等风险爆发。
7.3 风险热力图与判读
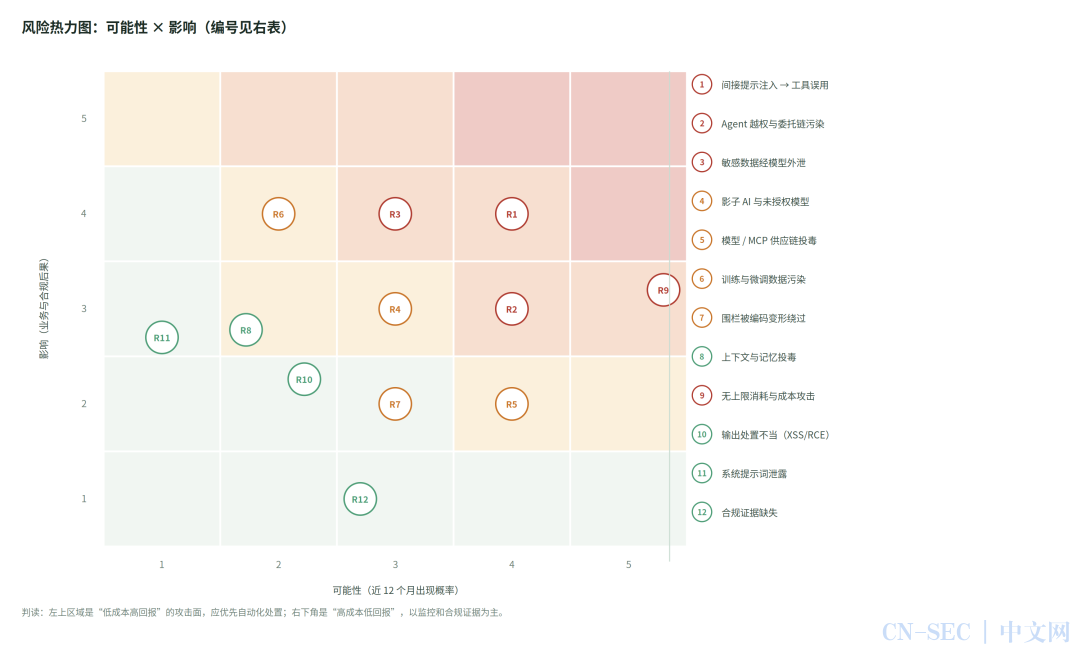
图 7-1风险热力图:横轴为可能性、纵轴为影响,颜色越深代表综合风险越高
热力图的价值在于资源分配,而不在于“知道有哪些风险”。三个判读规则:
· 右上角(高可能 × 高影响):必须自动化处置,不能依赖人工。这里的每一条延迟一天,期望损失都在累积。
· 左上角(低可能 × 高影响):以监控和预案为主。这类风险拦不住,但必须能快速发现并止血。
· 右下角(高可能 × 低影响):以流程和培训为主。技术上不值得投入大量资源,但会持续消耗人力。
7.4 风险演化的三条主线
把十加八条风险放在一起看,会发现它们沿着三条主线演化。理解主线比记住清单更重要——因为新风险会不断出现,但演化的方向是稳定的。
主线一:从“内容”到“行为”。 早期的 AI 风险都在内容层(说错话、生成有害内容),现在的风险在行为层(调错工具、删错文件、发错邮件)。这意味着检测重心必须从“文本分类”转向“行为序列分析”,也意味着纯内容安全的厂商会越来越吃力。
主线二:从“单轮”到“长期”。 记忆、委托链、持续会话,让攻击可以跨时间、跨会话布局。这直接挑战了当前“按会话分析”的架构——未来必须支持“按主体分析”,把一个人(或一个 Agent)数周内的所有交互当作一条时间线来看。
主线三:从“模型”到“系统”。 攻击目标正在从模型本身(越狱、窃取)转向模型所在的系统(工具链、MCP、身份、数据管道)。这也解释了为什么纯模型评测越来越不够用——被攻破的往往不是模型,而是模型周边的集成层。
八、前瞻:五个演进方向与三个可能被证伪的判断
这一章不做趋势罗列。每个方向只回答三个问题:今天的问题是什么、可能的解法长什么样、它对 AI-SPM 的架构意味着什么。最后一节给出三个我认为可能错的判断——以及如果错了,应该怎么调整。
8.1 从“声明式合规”到“可验证安全”
今天的围栏和管理体系有一个共同的弱点:它们都是声明式的。我说我配了策略,你要信;我说我通过了评估,你要信。但 AI 系统的行为无法静态推导,声明和事实之间的缝隙极大。这就是为什么“合规通过”和“真的安全”经常是两件事。
下一步的形态是策略即代码 + 对抗性回归:每一条安全策略不是一个配置项,而是一个包含“规则 + 测试用例 + 期望结果”的策略包。策略上线前,CI 流水线跑一遍对抗集;上线后,影子模式持续用真实流量验证。策略的“证据强度”由它能通过多少条对抗样本决定,而不是由条款编号决定。
这对架构的要求很具体:策略仓库要能版本化、回滚;对抗样本要能自动生成(不能靠人工攒);影子模式要与策略发布流水线打通。没有对抗回归的围栏,本质上是一个未被测试的组件。
8.2 AI 身份治理:从服务账号到能力令牌
Agent 正在成为组织里的“第一类非人类员工”,但身份体系还停在服务账号时代。三个具体问题:权限超配(为了让它能工作,给了一堆用不到的权限)、令牌长生不老(配一次用一年)、委托关系丢失(用户 A 让 Agent 办事,日志里只剩下 Agent 的账号)。
可能的方向是能力令牌(Capability Token):短期(分钟级)、范围受限(只含本次任务需要的工具)、可追溯(携带发起人与委托链)、可撤销(秒级生效)。这实际上是借鉴了零信任里的短期凭据思路,但增加了“委托链”这个 AI 特有的维度。
对 AI-SPM 的影响是根本性的:资产图谱的主干会从“模型-应用-数据”变成“身份-能力-数据”。因为真正决定风险的,不是“这个模型能做什么”,而是“这个身份此刻被授予了什么能力”。这也是为什么我们认为,未来的 AI-SPM 与 IAM 会深度耦合,而不是与 SIEM 耦合。
8.3 运行时免疫:把约束放到模型之外
“检测—响应”这套范式有一个天然的时间差:攻击发生在前,检测在后。对 AI 系统来说这个时间差尤其危险,因为一次工具调用就可能完成数据外发,等你告警,数据已经出去了。
所以长期看,重心会从“检测”转向“内生约束”,也就是让系统在设计上就不具备做坏事的路径。四个可落地的方向:
· 能力沙箱:默认拒绝,只开放白名单工具;工具的能力边界由代码强制,不由提示词声明。
· 参数类型系统:工具入参做严格 schema 校验(路径必须在工作目录内、URL 必须在白名单域、SQL 只允许 SELECT)。这一条能挡掉大量注入类攻击,成本极低但经常被忽略。
· 输出编码强制:模型输出进入下游系统前必须编码/转义,禁止直接拼接。R10 那类 RCE 的根因就在这里。
· 上下文完整性标签:给每个上下文片段打来源标签(用户输入 / 检索文档 / 工具返回 / 系统指令),模型侧按标签决定信任级别。这是学术界信息流控制(IFC)思路在 LLM 上的移植。
最后一条最值得关注,也最不成熟。如果模型能可靠地区分“用户说的话”和“文档里写的话”,间接提示注入的难度会上升一个数量级。目前的做法是在提示词里加分隔符和警告,这本质上是“请模型自觉”,并不是真正的隔离。真正的解法需要在训练或推理架构层面做,这也意味着它不会很快普及。
8.4 评测即安全:从“通过率”到“攻击成本”
LLM 应用的安全性无法通过代码审计得出,只能通过评测逼近。但当前的评测有两个问题:一是评测集静态,攻击者一旦知道题目就能针对性绕过;二是指标失真,“通过率 95%”既不能说明剩下的 5% 有多危险,也不能说明攻击者要花多少代价。
更稳定的指标是攻击成本:突破一次需要多少轮对话、多少 token、多少次尝试。这个指标的好处是它与攻击者的投入直接挂钩——防御的价值等于“把攻击成本抬到不划算”。它也更难被“刷”——因为你无法通过记住答案来降低对手的成本。
工程上的落地形态是持续红队 + 上线门禁:红队不是一年做一次的项目,而是持续运行的流水线;每次模型/提示词/工具变更都触发回归;不达标不允许发布。生产流量中被判定为攻击的样本,自动回流成新的评测用例——这样评测集会随时间变强,而不是变旧。
8.5 风险量化与可保性
AI 风险要进入财务报表,必须有货币化口径。路径大致是:事件频率 × 单次损失 = 年化期望损失(ALE)。频率可以从历史事件与红队结果推算,单次损失可以拆成数据量 × 单价 + 停机成本 + 罚款区间。这个方法不完美,但它能把“安全投入”从成本项变成风险对冲项,说服力完全不同。
难点在尾部风险。AI 事件的分布是典型的长尾:绝大多数是小事故,但一次严重的训练数据泄露可能直接触发监管处罚与集体诉讼。历史数据不足以估计尾部,这是精算上的硬伤。
由此可以推一个前瞻判断:未来可能出现 AI 专项保险,保费与 AI-SPM 成熟度挂钩。一旦成立,安全建设就有了外部经济激励——不再只是“合规要求”,而是“保费折扣”。前提是行业能形成标准化的损失数据与审计口径,这两样目前都缺。
8.6 三个可能被证伪的判断
前瞻性写作最大的风险是过度自信。所以这一节列出三个我自己的判断,以及它们可能错在哪里。
判断一:围栏不会消失,但会“下沉”。从外挂式的内容过滤,变成推理链路内的策略编译。
· 如果成立:围栏厂商需要转型为“策略编译 + 评测”的提供方,纯规则引擎会被淘汰。
· 如果错了:若推理侧始终无法内嵌策略,围栏会长期以外挂形态存在,但延迟压力会越来越大。
· 观察窗口:12–24 个月。
判断二:Agent 之间的交互会超过人机对话。观测重心从网关转向 A2A 协议。
· 如果成立:AI-SPM 需要新增 A2A 协议解析与 Agent 身份图谱,网关探针的价值相对下降。
· 如果错了:若 Agent 长期停留在“人下达指令、Agent 执行”的形态,网关仍是主战场。
· 观察窗口:18–36 个月。
判断三:监管会要求“可解释的拒绝”。用户有权知道自己的请求为什么被拒。
· 如果成立:LLM 研判的可解释性从加分项变成合规必需,黑箱评分模型不可用。
· 如果错了:若监管只要求“可审计”而非“可解释”,则内部留痕即可,成本大幅下降。
· 观察窗口:24–36 个月。
列出证伪条件的意义在于:它让判断变成可检验的假设,而不是立场。如果 24 个月后第一个判断被证伪,架构上应该增加的是“网关侧的深度解析能力”,而不是“推理侧集成”。这比争论“围栏会不会消失”有用得多。
九、落地路径、组织与度量
9.1 三阶段:先可见,再可控,最后可证
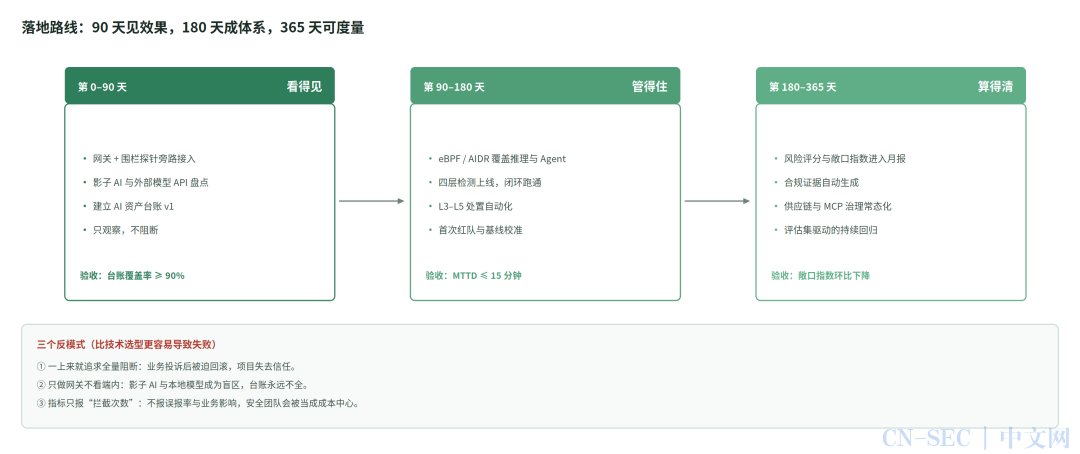
图 9-1三阶段落地路线:每阶段有明确的能力边界与验收标准
阶段划分的逻辑不是“功能多少”,而是“风险承担能力”。第一阶段只观察不阻断,目的是建立信任;第二阶段开始处置,但限定在可逆动作;第三阶段才引入阻断与吊销。跳过任何一步,都会在组织层面遇到阻力。
表 9-1三阶段的交付与退出条件
|
阶段 |
关键交付 |
不做什么 |
退出条件 |
|
0–90 天 |
台账 v1、影子 AI 清单、围栏影子模式 |
不做阻断、不做评分 |
台账覆盖率 ≥ 90%,影子模式跑满 2 周 |
|
90–180 天 |
四层检测、闭环流程、L3–L5 自动化 |
不做 L6/L7 自动处置 |
误报率 ≤ 30%,MTTD ≤ 15 分钟 |
|
180–365 天 |
敞口指数、合规证据、供应链治理 |
不追求“零事件” |
审计准备时间下降 70%,回归通过率 ≥ 95% |
9.2 组织:AI 安全运营中心(ASOC)的最小配置
不建议为 AI 安全单独建一个大团队。可行的做法是在现有 SOC 里设一个 3–5 人的虚拟单元,职责边界清晰:
表 9-2ASOC 的最小团队配置
|
角色 |
人数 |
职责 |
能力要求 |
|
AI 安全负责人 |
1 |
策略制定、跨部门协调、向管理层汇报 |
懂 AI 架构 + 懂合规 |
|
检测工程师 |
1–2 |
规则编写、基线调优、误报治理 |
会写规则、懂数据分析 |
|
红队 / 评测 |
1 |
对抗样本、回归集、上线门禁 |
有攻防经验,理解模型行为 |
|
平台运维 |
0.5–1 |
探针部署、容量、可用性 |
云原生 + 可观测性背景 |
一个现实提醒:这类人极其稀缺,且大多在业务团队里。所以更现实的路径是“安全团队出方法与工具、业务团队出人”——把检测规则的编写下放到业务侧的 AI 工程师,安全团队提供框架、评审与平台。这比死等一个全栈 AI 安全专家要快得多。
9.3 度量:四个层次,十二个指标
指标设计的原则是“每一层只回答一个问题”。混在一起会导致“指标很好看但没人知道该做什么”。
表 9-3四层十二项度量指标
|
层次 |
回答的问题 |
指标 |
目标(经验) |
|
可见性 |
我们知道多少 |
资产台账覆盖率、影子 AI 识别率、流量覆盖率 |
≥ 90% / ≥ 80% / ≥ 95% |
|
有效性 |
拦得住吗 |
围栏绕过成功率、检测召回率、误报率 |
≤ 5% / ≥ 90% / ≤ 30% |
|
效率 |
快不快 |
MTTD、MTTA、MTTR、自动处置率 |
≤ 15min / ≤ 30min / ≤ 4h / ≥ 60% |
|
价值 |
值不值 |
敞口指数环比、审计准备时间、事件复发率 |
下降 / −70% / ≤ 10% |
有一个指标必须单独说:事件复发率。它衡量“同类事件是否再次发生”,是唯一能证明闭环真的闭合的指标。其他指标都可以通过调整口径变好看,只有复发率不行——它对应的是真实世界的再次发生。
9.4 四个反模式
反模式一:先买设备,后想场景。 结果是一堆探针装在机房里,没人看数据。正确顺序是先用两周做一次资产盘点与流量分析,明确“最想解决哪三个问题”,再决定装什么。
反模式二:追求全量阻断。 上线第一天就开阻断,第一次误拦导致业务投诉,然后被迫全量回滚,项目从此失去信任。正确做法是影子模式跑够两周,先证明准确率,再逐级放开。
反模式三:只做网关。 看起来“全覆盖”,实际端内、东西向、本地模型全是盲区。影子 AI 治理在这一架构下永远做不完——因为最需要管的那些,恰好不走网关。
反模式四:指标只报拦截次数。 不报误报率、不报业务影响,安全团队会被当成成本中心。管理层看到的应该是“敞口下降了多少、避免了多少潜在损失”,而不是“拦了多少次”。
十、结论与建议
把整份报告压缩成十条可以直接拿去用的判断:
01AI-SPM 的度量单元是行为,不是配置。任何以“配置检查”为核心的方案,在 AI 场景下都会迅速失效。选型时先问:它能不能还原一条完整的调用链。
02探针决定可见性,平台决定价值。只有探针没有平台,是一堆日志;只有平台没有探针,是无源之水。两者必须同源设计,不能拼接。
03围栏的 KPI 是“判黑未拦率”,不是拦截次数。影子模式是唯一能测出这个指标的手段,应该在项目第一周就上线。
04网关必须做,但不能只做网关。端内与东西向的盲区,会让“资产台账”永远停在 60% 覆盖率。
05闭环的瓶颈在研判,不在检测。把资源投在置信度校准、上下文补齐、误报治理上,回报远高于再加一层检测规则。
06处置要设计成阶梯,且前三级必须无感。不敢拦是组织问题,解法是降低每一级动作的业务代价,而不是加强说服。
07取证的关键是“记录当时的状态”,不是“记录输入输出”。模型指纹、策略版本、检索证据、采样种子,缺一项就无法在监管问询时自证。
08前瞻风险要看“早期信号”,不要等案例。委托链断裂、能力漂移、记忆异常,这些今天就能写成检测规则。
09落地的顺序是可见→可控→可证,不能跳。第一阶段就上阻断的项目,失败率最高。
10最终的唯一硬指标是事件复发率。它无法被口径美化,也最能说明这套体系是否真的在工作。
如果只能记住一句话:AI 安全不是把传统安全设备换个名字,而是把“观测单元”从配置改成行为、把“分析单元”从单点改成关系、把“处置单元”从阻断改成阶梯。 这三件事做到了,架构自然会长成“节点 + 平台”的样子;做不到,堆再多探针也只是更贵的日志系统。
附录
附录 A术语表
表 A-1核心术语
|
术语 |
全称 / 含义 |
在本报告中的用法 |
|
AI-SPM |
AI Security Posture Management |
AI 安全态势管理,强调持续度量与闭环 |
|
AIDR |
AI Detection and Response |
面向 AI 运行时的检测与响应,侧重主机与推理侧 |
|
AI-BOM |
AI Bill of Materials |
AI 物料清单,含模型、提示词、工具、数据、依赖 |
|
NHI |
Non-Human Identity |
非人类身份,含服务账号、Agent 令牌、工具凭据 |
|
MCP |
Model Context Protocol |
模型上下文协议,Agent 调用工具的标准接口 |
|
A2A |
Agent-to-Agent |
智能体之间的通信协议 |
|
OCSF |
Open Cybersecurity Schema Framework |
开放网络安全 Schema 框架,事件归一化的基础 |
|
影子模式 |
Shadow Mode |
策略只记录不执行的运行方式,用于度量策略有效性 |
|
能力漂移 |
Capability Drift |
Agent 实际可调用能力超出其声明范围的现象 |
|
爆炸半径 |
Blast Radius |
一次攻击可影响的最大资产与数据范围 |
附录 B统一事件模型(19 个核心字段)
表 A-2AI-OCSF 扩展的 19 个核心字段
|
组 |
字段 |
类型 |
说明 |
|
身份 |
subject_id |
string |
发起主体(用户 / Agent / 服务) |
|
subject_type |
enum |
human / agent / service |
|
|
on_behalf_of |
string |
委托链中的原始发起人,无委托时为空 |
|
|
session_id |
string |
跨组件一致的会话标识 |
|
|
动作 |
action |
enum |
prompt / completion / tool_call / file_access / net_connect |
|
tool_name |
string |
工具或函数名 |
|
|
params_digest |
string |
入参摘要(脱敏后的哈希) |
|
|
decision |
enum |
allow / block / throttle / degrade |
|
|
对象 |
object_type |
enum |
model / document / table / endpoint |
|
object_id |
string |
对象标识(模型名、文档 ID、表名) |
|
|
data_class |
enum |
public / internal / confidential / pii |
|
|
上下文 |
policy_version |
string |
判定时生效的策略版本 |
|
model_fingerprint |
string |
模型名 + 权重哈希 + 框架版本 |
|
|
risk_score |
float |
当次事件的实时风险分 |
|
|
detector |
string |
命中的检测层与规则 ID |
|
|
confidence |
float |
检测置信度 0–1 |
|
|
src_ip / dst_domain |
string |
网络路径 |
|
|
timestamp |
datetime |
UTC,毫秒精度 |
|
|
evidence_ref |
string |
证据包引用(快照存储路径) |
附录 C检测规则样例
规则采用声明式写法,便于版本管理与回归测试。以下三条覆盖不同层次:
# 1) 能力漂移:出现未声明的工具调用 id: AI-CAP-001level: highwindow: 5m match: tool_call.name NOT IN asset.declared_tools assert: subject_type == 'agent' AND decision == 'allow' action: alert + collect_session(3) # 2) 凭据读取后外联:典型窃密链 id: AI-EXFIL-012level: criticalwindow: 10m seq: file_access(path ~ '.aws/credentials|.ssh/id_') -> net_connect(egress=true) assert: same(session_id) action: block + isolate_endpoint # 3) 影子 AI:非白名单域的模型 API 调用 id: AI-SHADOW-004level: mediumwindow: 1h match: net_connect.sni NOT IN allowlist AND payload.shape == 'llm_api' assert: subject_type == 'human' action: alert + attribute_to_department
附录 D参考标准与资料来源
本报告的可溯源引用如下。标注“工程经验值”的量化阈值来自实践总结,未直接引用文献,使用时需按自身业务重新标定。
表 A-3参考标准与资料来源
|
编号 |
来源 |
版本 / 时间 |
本报告中的用途 |
|
[1] |
OWASP. Top 10 for LLM Applications |
2025 版 |
LLM 风险分类(R1、R6、R10 等) |
|
[2] |
OWASP. Agentic AI Security / AIVSS |
2025 |
Agent 风险分类(R2、R8) |
|
[3] |
MITRE ATLAS(AI 对抗威胁矩阵) |
持续更新 |
攻击技术映射(R9 等) |
|
[4] |
NIST. AI Risk Management Framework (AI 100-1);Generative AI Profile (AI 600-1) |
2023-01 / 2024-07 |
合规引擎的四项功能映射 |
|
[5] |
ISO/IEC 42001:2023 人工智能管理体系 |
2023 |
管理体系要求与控制项 |
|
[6] |
ISO/IEC 23894:2023 人工智能风险管理指南 |
2023 |
风险评分与处置流程 |
|
[7] |
欧盟《人工智能法案》Regulation (EU) 2024/1689 |
2024-07 |
高风险场景的合规义务 |
|
[8] |
TC260-003《生成式人工智能服务安全基本要求》 |
2024-02 |
语料与生成内容的安全要求 |
|
[9] |
《生成式人工智能服务管理暂行办法》 |
2023-07 施行 |
服务提供者的主体责任 |
|
[10] |
《人工智能生成合成内容标识办法》 |
2025-09 施行 |
输出侧标识与追溯要求 |
|
[11] |
NVD / 公开漏洞库:CVE-2025-49596、CVE-2025-3248、CVE-2024-37032、CVE-2024-5565、CVE-2025-32711 |
2024–2025 |
供应链与输出处置风险的实证 |
|
[12] |
Cloud Security Alliance. AI Controls Matrix |
2024 |
控制项与云环境的映射 |
说明:本报告保持厂商中立,不针对任何特定产品的能力做评价;文中的架构与指标均以通用企业环境为背景,金融、运营商等强监管行业在落地时应结合行业细则调整阈值与处置权限。
表 A-4版本记录
|
版本 |
日期 |
变更内容 |
|
v1.0 |
2026-10 |
初版:问题定义、总体架构、遥测节点、分析引擎、业务应用、闭环、风险图谱、前瞻与落地路径 |
本报告的观点仅代表当前认知。欢迎用具体场景与数据来挑战——被证伪的判断,比被重复的结论更有价值。
原文始发于微信公众号(AI安全推进计划):AI 安全态势管理 :AI-SPM前端遥测节点 + 平台,架构、闭环与前瞻
- 左青龙
- 微信扫一扫
-
- 右白虎
- 微信扫一扫
-
评论